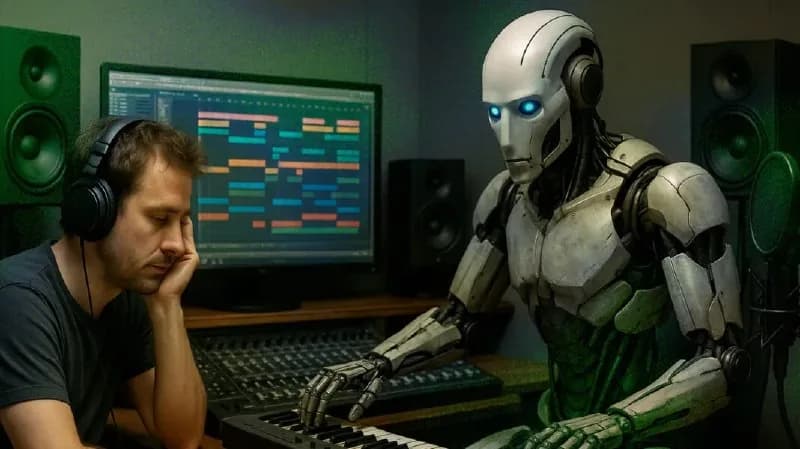
В текущем 2026 году музыкальная индустрия столкнулась с беспрецедентным вызовом, связанным с технологиями генеративного искусственного интеллекта. Исследования показывают, что около десяти миллионов музыкальных треков, защищенных действующим авторским правом, были включены в наборы данных для обучения нейросетей без согласия авторов, исполнителей или правообладателей. Этот процесс, который разработчики ИИ называют «индексацией» или «сбором данных», вызвал волну возмущения среди творческого сообщества и привел к серии громких судебных разбирательств, способных радикально изменить ландшафт интеллектуальной собственности в цифровой среде.
Механика сбора данных и проблема отсутствия лицензий
Процесс обучения современных моделей генеративного аудио строится на поглощении колоссальных объемов информации. Для того чтобы нейросеть научилась имитировать структуру мелодии, гармонию или специфический тембр вокала, она должна проанализировать миллионы часов аудиозаписей. Разработчики систем автоматизированного создания музыки использовали для этих целей широкий спектр открытых источников: от публичных веб-ресурсов и стриминговых платформ до нелицензионных онлайн-архивов и специализированных музыкальных форумов.
Проблема заключается в том, что подавляющее большинство правообладателей не давали своего явного согласия на использование их интеллектуальной собственности в качестве «сырья» для алгоритмов машинного обучения. Компании-разработчики в ряде случаев даже не предпринимали попыток связаться с авторами или звукозаписывающими лейблами для обсуждения условий лицензирования. Вместо этого была выбрана тактика массового автоматизированного скачивания данных, что фактически приравнивает использование миллионов произведений к несанкционированному копированию в промышленных масштабах.
Почему стандартные методы защиты оказались неэффективны
Традиционные инструменты защиты авторских прав, такие как системы цифровых отпечатков (digital fingerprinting), оказались бессильны перед лицом технологий сбора данных для нейросетей. В отличие от случаев прямого пиратства, когда контент распространяется в открытом доступе, здесь происходит деконструкция аудио на мельчайшие математические векторы. В результате исходная композиция перестает существовать в привычном виде, превращаясь в набор статистических параметров, что значительно усложняет процесс доказывания факта использования конкретного произведения в суде.
Правовые коллизии и Бернская конвенция
Юридическое сообщество в 2026 году ведет жаркие дискуссии о том, подпадает ли обучение ИИ под концепцию добросовестного использования (fair use). Разработчики алгоритмов настаивают на том, что их деятельность носит трансформационный характер: они не копируют музыку, а лишь извлекают из нее паттерны для создания принципиально новых продуктов. Однако правозащитники указывают на фундаментальные нормы Бернской конвенции, которая охраняет права авторов на воспроизведение их произведений в любой форме.
Согласно международным правовым стандартам, правообладатель имеет исключительное право контролировать использование своей работы. Если нейросеть обучается на конкретном музыкальном каталоге, это создает прямую конкуренцию для самих авторов, чья музыка была использована для создания системы. Многие эксперты подчеркивают, что использование защищенного контента в коммерческих целях без выплаты роялти является грубым нарушением основ интеллектуальной собственности, требующим системного пересмотра регуляторных норм.
Реакция индустрии и первые судебные прецеденты
В ответ на действия технологических гигантов крупнейшие ассоциации музыкальной индустрии начали консолидировать усилия. В судах различных юрисдикций уже рассматриваются коллективные иски, в которых истцы требуют не только компенсаций за прошлые периоды, но и удаления своих произведений из обучающих баз данных, а также введения обязательной системы лицензирования для всех разработчиков ИИ. Эти процессы создают прецеденты, которые в ближайшие годы могут лечь в основу нового международного законодательства.
Интересно, что осознавая риски, некоторые технологические компании начали менять свою стратегию. Понимая, что бесконечные судебные тяжбы могут заблокировать развитие их продуктов, разработчики начинают инвестировать в создание «чистых» наборов данных. Они заключают партнерские соглашения с крупными звукозаписывающими лейблами, покупая права на использование каталогов для обучения. Однако этот путь требует значительных финансовых вложений и времени, что ставит в неравное положение стартапы, не обладающие сопоставимыми ресурсами.
Последствия для музыкантов и авторов контента
Для индивидуальных авторов, независимых музыкантов и небольших студий ситуация остается крайне неопределенной. Многие из них обнаруживают, что их творчество стало частью глобальной модели, которая теперь предлагает пользователям создавать музыку «в стиле конкретного исполнителя» буквально за несколько секунд. Это не только лишает авторов потенциальных доходов от стриминга, но и обесценивает их уникальный творческий почерк, который был сформирован годами упорной работы.
В этих условиях правообладателям рекомендуется более тщательно следить за условиями использования своих произведений на различных платформах. Появление специальных реестров, в которых авторы могут заявить о своем запрете на использование музыки для обучения ИИ, становится новой реальностью. Развитие технологий блокчейн также может предложить инструменты для отслеживания использования контента, позволяя авторам автоматически получать отчисления при каждом обращении модели к их произведениям.
Итог: что это значит для будущего технологий
Ситуация с использованием десяти миллионов треков для обучения ИИ знаменует окончание эпохи «дикого запада» в области генеративных технологий. Становится очевидным, что правовая среда будет стремительно ужесточаться: разработчикам придется либо договариваться с правообладателями, либо ограничивать свои обучающие выборки исключительно контентом с открытой лицензией (Public Domain). Это приведет к удорожанию технологий ИИ, но обеспечит этическую чистоту создаваемых продуктов.
В долгосрочной перспективе мы увидим становление рынка лицензирования данных для нейросетей, где музыка станет таким же товаром, как и любой другой ресурс. Для музыкантов это означает необходимость адаптации к новым правилам игры, где защита интеллектуальной собственности должна начинаться еще на этапе загрузки трека на площадки. В конечном счете, текущие споры приведут к созданию более справедливой и прозрачной системы, в которой технологический прогресс будет развиваться в гармонии с защитой прав тех, кто создает культурную ценность нашего времени.