Группа исследователей совершила значимый прорыв в области исторической криптографии, успешно расшифровав два сообщения, зашифрованных с помощью знаменитой немецкой машины «Энигма». Использование современных больших языковых моделей (LLM) позволило справиться с задачей, которая десятилетиями ставила в тупик профессиональных криптоаналитиков и энтузиастов.
1. Роль искусственного интеллекта в дешифровке
Для решения исторической головоломки были задействованы передовые нейросетевые архитектуры, разработанные компаниями OpenAI и Anthropic. Модели Astra и Opus проявили исключительные способности в анализе сложных паттернов, которые ранее считались практически не поддающимися автоматизированному распознаванию без специализированных вычислительных мощностей. В отличие от классических алгоритмов, которые перебирают все возможные комбинации настроек роторов «Энигмы», современные ИИ-модели смогли применить контекстуальный анализ к фрагментам текста, что позволило значительно сократить пространство поиска.
Процесс работы с нейросетями заключался в подаче на вход зашифрованных данных, которые были накоплены в архивах проекта Crypto Cellar. Исследователи отмечают, что ИИ не просто механически перебирал ключи, а «понимал» структуру языка того времени, учитывая специфические военные сокращения и особенности немецкого синтаксиса периода 1940-х годов. Это позволило алгоритмам отсеивать тысячи неверных вариантов на ранних этапах, фокусируясь на наиболее вероятных лингвистических конструкциях.
2. Исторический контекст и сложность задачи
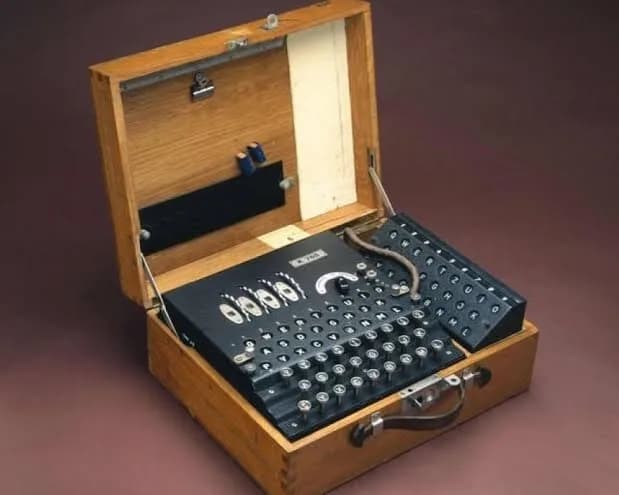
Машина «Энигма» представляла собой электромеханическое устройство с роторами, обеспечивающее многоуровневое шифрование, которое менялось с каждым нажатием клавиши. В годы Второй мировой войны союзникам удавалось взламывать эти шифры благодаря работе группы математиков в Блетчли-парке, однако многие сообщения, перехваченные в конце войны, так и остались загадкой из-за утраты ключевых настроек или повреждения передаваемого сигнала.
Два расшифрованных сообщения, которые оставались «немыми» на протяжении более 80 лет, представляли собой сложные фрагменты, содержащие специфические оперативные данные. Ранее попытки взломать их с помощью традиционных компьютерных программ часто заканчивались неудачей, так как сообщения были слишком короткими для статистического анализа частотности букв, на котором строились ранние методы криптоанализа. Использование LLM изменило этот подход, превратив задачу из сугубо математической в задачу распознавания образов и контекстуальной реконструкции.
3. Технологические особенности процесса
Применение нейросетей Astra и Opus потребовало предварительной подготовки данных. Исследователи создали специальные промпты, которые задавали контекст работы машины: имитировались условия передачи данных, вероятные типы сообщений и возможные ошибки операторов. Это позволило моделям работать в рамках заданных параметров, что критически важно при анализе зашифрованного текста, где любая опечатка или искажение сигнала полностью меняют результат дешифровки.
Важным аспектом стала способность нейросетей к самокоррекции. В процессе работы модели предлагали несколько гипотез расшифровки, которые затем перепроверялись через дополнительные скрипты. Такой тандем «человек — ИИ» позволил достичь результата, который ранее был недоступен даже при использовании суперкомпьютеров 1990-х и 2000-х годов. Нейросети эффективно справились с задачей восстановления утраченных фрагментов текста там, где обычные методы «спотыкались» о шумы в радиоэфире.
4. Перспективы для криптографии и науки
Успех данного эксперимента демонстрирует, что возможности нейросетей выходят далеко за рамки написания текстов или написания программного кода. В исторической науке это открывает возможность для систематической обработки тысяч неразгаданных архивов времен мировых конфликтов. Многие документы, хранящиеся в государственных хранилищах, могут содержать ценную информацию, которая была зашифрована и забыта, поскольку у историков не было инструментов для её прочтения.
Кроме того, данное исследование ставит новые вопросы перед современной криптографией. Если языковые модели способны находить закономерности в шифрах, которые считались максимально защищенными, это заставляет разработчиков современных систем шифрования пересмотреть стандарты безопасности. Очевидно, что в будущем ИИ станет основным инструментом как для защиты данных, так и для их потенциального взлома, что требует развития методов квантово-устойчивого шифрования уже сегодня.
Чего избегать при работе с ИИ в криптоанализе
Главная ошибка, которую совершают новички при попытке использовать нейросети для взлома шифров, — это слепое доверие результату. LLM склонны к «галлюцинациям», то есть генерации текста, который выглядит логично, но не имеет отношения к реальности. При анализе исторических сообщений крайне важно проверять каждый символ и каждую букву на соответствие техническим спецификациям «Энигмы». Если модель выдает расшифровку, которая противоречит известным принципам работы роторных машин, такой результат должен быть немедленно отвергнут.
Также не стоит переоценивать универсальность инструментов. Не каждая задача требует использования самых мощных моделей. Для простых шифров подстановки достаточно базовых алгоритмов, в то время как LLM эффективны именно там, где присутствует высокий уровень неопределенности и контекстуальной сложности. Попытка применить нейросети для взлома современных криптографических протоколов (например, AES-256) без понимания их математической природы приведет лишь к потере вычислительных ресурсов и отсутствию значимых результатов.
Итог
Успешная расшифровка сообщений «Энигмы» с помощью нейросетей подтверждает, что большие языковые модели стали мощным инструментом для анализа данных с высокой степенью энтропии. Это событие не только закрывает исторические пробелы, но и наглядно показывает, как меняются подходы к изучению прошлого с приходом технологий искусственного интеллекта. Будущее криптоанализа лежит на стыке классической математики и машинного обучения, где ИИ берет на себя рутинную работу по распознаванию контекста, позволяя исследователям сосредоточиться на интерпретации полученных данных.