Современные инструменты на базе искусственного интеллекта стали неотъемлемой частью повседневной жизни миллионов людей. Однако за удобством мгновенных ответов скрывается сложный процесс дообучения моделей, который зачастую требует участия человека. Согласно актуальным данным, компания OpenAI активно привлекает сторонних специалистов для разметки и оценки диалогов, что ставит под вопрос приватность персональных данных, передаваемых чат-боту.
1. Механика обучения ИИ с участием человека
Обучение больших языковых моделей не ограничивается автоматической обработкой массивов данных из интернета. Чтобы сделать ответы нейросети более точными, этичными и полезными, разработчики внедряют метод обучения с подкреплением на основе отзывов людей, известный как RLHF (Reinforcement Learning from Human Feedback). В рамках этого процесса живые сотрудники анализируют диалоги, которые пользователи ведут с искусственным интеллектом в повседневном режиме.
Специалисты, нанимаемые через подрядные организации, получают доступ к фрагментам переписок, чтобы оценить качество сгенерированных ответов. Задача таких оценщиков заключается в ранжировании вариантов текста, проверке фактов и выявлении потенциальных ошибок или галлюцинаций модели. Этот этап критически важен для минимизации токсичности и повышения релевантности ИИ, однако он неизбежно создает человеческий фактор в цепочке обработки данных, которые пользователи могли считать сугубо конфиденциальными.
Масштабы такой деятельности впечатляют: сотни специалистов по всему миру ежедневно просматривают тысячи запросов. За эту кропотливую работу, требующую высокой концентрации и навыков критического мышления, подрядчики предлагают почасовую оплату, начинающуюся от 50 долларов. Для многих это становится способом удаленного заработка, но для пользователей сервиса новость о том, что их личные или рабочие переписки могут быть изучены посторонними лицами, стала поводом для серьезного беспокойства.
2. Почему пользователи остаются в неведении
Основная проблема заключается в прозрачности политики обработки данных. Хотя в пользовательских соглашениях OpenAI обычно прописываются пункты о возможности использования диалогов для улучшения продуктов, большинство пользователей не вникают в юридические тонкости при регистрации. Свыше 900 миллионов человек по всему миру ежедневно обращаются к нейросети, воспринимая окно чата как личное пространство, защищенное алгоритмами, а не как открытый для человеческого взгляда архив.
Ситуация осложняется тем, что грань между обезличенными данными и конфиденциальной информацией крайне тонка. Пользователи часто вводят в ChatGPT подробности своих бизнес-стратегий, программный код, медицинские диагнозы или личные переживания, полагая, что данные попадают только в «цифровой мозг». Отсутствие явного уведомления о том, что конкретный чат в данный момент может быть выбран для ручной проверки, создает ложное чувство защищенности.
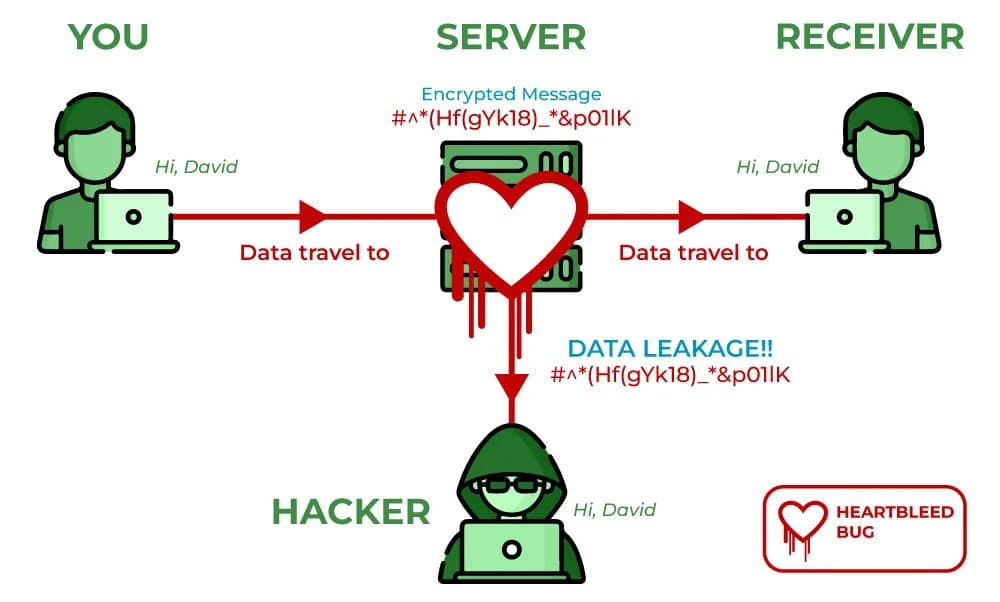
Даже если система анонимизации работает исправно, риск утечки контекста остается высоким. Если в ходе диалога пользователь указывает специфические детали своей деятельности, местоположение или имена коллег, человеческий оператор неизбежно знакомится с этой информацией. В эпоху, когда утечки данных происходят регулярно, вопрос о том, кто именно имеет доступ к серверам и какая квалификация у этих внешних подрядчиков, становится ключевым для корпоративной и личной безопасности.
3. Роль человеческого труда в автоматизированном мире
Работа по разметке данных требует не просто знания языка, но и глубокого понимания контекста, нюансов культуры и специфики профессиональных сфер. Именно поэтому OpenAI и другие гиганты индустрии ИИ предпочитают нанимать людей, а не доверять эту задачу другим алгоритмам. Человеческое суждение остается эталоном, на который равняется нейросеть в процессе своей эволюции.
Для самих сотрудников, занимающихся анализом диалогов, работа представляет собой монотонный процесс оценки «качества логики» ответов. Они должны следить за тем, чтобы ИИ не давал вредных советов, не нарушал правила безопасности и не демонстрировал предвзятости. По сути, эти люди выступают в роли «цифровых учителей», формирующих мировоззрение модели. Без этого этапа нейросети были бы гораздо менее эффективными и опасными в использовании.
Однако, несмотря на технологическую необходимость, модель взаимодействия с подрядчиками вызывает вопросы к этике процесса. Нанимаемые специалисты часто работают в условиях жестких дедлайнов, что может влиять на глубину анализа. В то же время сами пользователи оказываются в роли невольных «поставщиков данных», чьи запросы становятся учебным материалом без их прямого и осознанного согласия на передачу информации третьим лицам для ручного изучения.
4. Чего избегать: как обезопасить свои данные
Главная ошибка современного пользователя — доверять облачным сервисам информацию, которая имеет гриф «секретно» или «коммерческая тайна». Многие воспринимают ИИ как надежный сейф, забывая, что сервис работает на облачной архитектуре, а любые данные, передаваемые в чат, теоретически могут стать достоянием третьих лиц, если это предусмотрено политикой компании или необходимо для обучения нейросети.
Чтобы минимизировать риски, эксперты по кибербезопасности рекомендуют придерживаться нескольких правил:
- Никогда не вводите в чат пароли, ключи доступа или номера банковских счетов.
- Избегайте указания имен, адресов и других персональных данных, которые могут идентифицировать вас или ваших близких.
- Не используйте нейросеть для обработки корпоративной документации, которая является интеллектуальной собственностью вашей компании, если вы не используете специальную Enterprise-версию с гарантией приватности.
- Регулярно очищайте историю чатов и используйте настройки конфиденциальности, позволяющие отключить обучение модели на ваших данных, если такая опция доступна в настройках вашего аккаунта.
Помните, что любое сообщение, отправленное в публичный или даже условно «личный» чат, становится частью глобального набора данных. Даже если компания OpenAI заявляет о принятии всех мер для защиты приватности, человеческий фактор невозможно исключить полностью, пока живые люди участвуют в процессе обучения моделей.
Итог
Ситуация с привлечением людей к анализу переписок в ChatGPT обнажает фундаментальную проблему доверия между пользователем и разработчиком ИИ. Технологический прогресс требует участия человека в обучении нейросетей, и этот процесс вряд ли будет остановлен в ближайшем будущем. Однако пользователям необходимо изменить свое отношение к цифровым инструментам: воспринимайте диалог с чат-ботом как общение в публичном пространстве. Только осознанный подход к тому, какую информацию вы доверяете алгоритмам, поможет сохранить конфиденциальность в мире, где каждый ваш вопрос может стать предметом анализа.